最近話題のJevを学ぶために、ゲームを作ってみました。
以前Pyladies Shizuokaに参加したときに、StackChanというAI連携可能なデスクトップロボットが話題になりました。やはりハードなだけあって2万円近くと手を出しにくい値段だったので、PyxelでStackChanみたいな見た目のキャラに話しかけると表情が変わるゲームを作りました。 (動画はリポジトリのREADMEに添付しています)
要件
- Pyxelでロボット風のキャラクターを表示する(画面・目・口・アンテナのあるスタックチャン風の見た目)
- キーボードで話しかけたい言葉を英語で入力できる。ポップアップやIMEには頼らず、ゲーム画面1つで完結させる
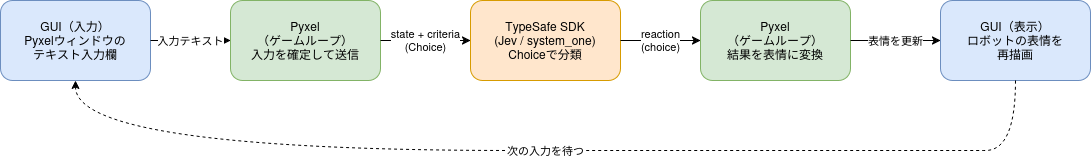
- 入力内容をJevに渡し、「褒め言葉」「愚痴」「悲しい話」「面白い話」「その他」の5パターンに分類してもらう
- 分類結果に応じて表情(喜怒哀楽+通常)を切り替える。「その他」は相槌を打つような、うなずきモーションを追加
- キャラは表情を返すだけでセリフは返さない。会話の記憶も持たせず、毎回の入力を独立に判定する
「学習」や「対話」の要素は思い切って捨て、判定エンジンとしてJevを1回呼ぶだけの、なるべくシンプルな構成にしました。本家StackChanは音声認識・音声合成・実機のサーボモーターまで備えていますが、今回はそのうち「話しかけると表情が変わる」という核だけを、PC上のソフトウェアだけで再現した形です。
なぜLLMではなくJevにしたのか
今回のように「入力を数個のカテゴリに振り分けるだけ」のタスクに、汎用LLMのフル機能(長文生成や多ターン対話)はオーバースペックでJevの使いどころでは…?と考えました。
Jevは2026年9月にTypeSafe AIが発表した、テキストを生成しない専用モデルです。TypeSafe自身は「System Oneモデル」と呼んでいます。プログラムの状態を受け取り、型付きの決定を確率つきで1回で返す設計で、フロンティアLLMより40〜200倍高速、入力100万トークンあたり0.042ドル(出力は無料)とされています。TypeSafeが公開しているPongのデモでは、同じ12秒間にJevは47回の判定を返したのに対し、対話用LLMは2〜3回だったそうです*1。ゲームのように「入力のたびに即座に反応がほしい」用途とは相性が良いと感じました。
従来のテキスト分類比べると手軽
もう一つの比較対象が、BERTなどをfine-tuningする従来のテキスト分類です。こちらはtransformersなどのライブラリでラベル付き学習データ(最低でも各カテゴリ数十〜数百件)を用意し、GPU環境で学習を回し、精度を評価し、カテゴリを変えるたびに再学習する必要があります。個人のちょっとした制作でこの工程をこなすのは、正直ハードルが高いです。
JevのSystem One APIは、この工程を丸ごと「カテゴリを自然言語で説明する」だけに置き換えてくれます。後述のコードのようにcriteriaという辞書に説明文を書くだけで、その場で分類器が動きます。学習データもGPUも不要で、判定基準を変えたければ辞書の文字列を書き換えるだけです。精度でfine-tuning済みモデルに勝るという話ではなく、学習データを集める工数ゼロで「動くもの」がすぐ作れる、プロトタイピングの速さが魅力だと思いました。
PythonのSDKを使って実装
実装はpip install typesafe-sdkで入るSDKを使います。
from typesafe_sdk import Choice, TypeSafeClient

client = TypeSafeClient()  # TYPESAFE_API_KEY を自動で読み込む

CRITERIA = {
    "smile": "A compliment or something happy and positive.",
    "angry": "A complaint, criticism, or something negative and aggressive.",
    "cry":   "Sad or difficult news.",
    "lol":   "A very funny story or a strong joke.",
    "nod":   "None of the above.",
}

def judge(text: str) -> str:
    if not text.strip():
        return "nod"
    try:
        res = client.system_one(
            state=text,
            questions={"reaction": Choice(
                instructions="Decide how this character should react to what was just said.",
                criteria=CRITERIA,
            )},
        )
        return res.answers["reaction"].choice
    except Exception:
        return "nod"
stateに判定したい文字列をそのまま渡し、Choiceのcriteria辞書のキーがそのまま結果として返ってくるので、Python側はそのまま分岐に使えます。SDKにはChoice(多肢選択)の他に、Yes/No系のNoulや数値スケールのScoreもあり、今回は5表情から1つ選ばせたいのでChoice一択でした。通信失敗時は「あいづち」にフォールバックし、ゲームが落ちないようにしています。
表情の描画自体はPyxelのcircやlineだけで組んだ簡単なドット絵ですが、「あいづち」ではうなずき、「爆笑」では画面が震えるモーションをpyxel.camera()でキャラ全体をずらして表現しています。
REACTION_TO_EXPR = {
    "smile": "joy", "angry": "anger", "cry": "sorrow", "lol": "fun", "nod": "normal",
}

class RobotFaceApp:
    NOD_FRAMES = 24    # うなずきモーションの長さ(フレーム数)
    SHAKE_FRAMES = 36  # 震えモーションの長さ(フレーム数)

    def __init__(self):
        self.input_buffer = ""    # 画面下の入力欄にたまっている文字列
        self.expr = "normal"      # draw_robot()側の表情分岐で使うキー
        self.nod_timer = 0
        self.shake_timer = 0

    def on_enter_pressed(self):
        text = self.input_buffer.strip()
        reaction = judge(text)             # ここで先ほどのJev呼び出しが走る

        self.expr = REACTION_TO_EXPR[reaction]

        self.nod_timer = self.shake_timer = 0
        if reaction == "nod":
            self.nod_timer = self.NOD_FRAMES      # うなずきモーションを開始
        elif reaction == "lol":
            self.shake_timer = self.SHAKE_FRAMES  # 震えモーションを開始
まとめ
「入力をいくつかのカテゴリに振り分ける」程度のタスクなら、汎用LLMより専用の分類モデルの方がコスト・速度の両面で理にかなっています。BERTのfine-tuningと比べても学習データ無しで動かせるので、個人開発のハードルはぐっと下がった気がします。
ただ、今回試したのは日常会話レベルの分類です。専門知識が要る業界特化の判定でどこまで実用的な精度が出るかはまだ未知数で、そこは素直に自前でモデルを作る/fine-tuningする方を検討すべきなのかもしれません。汎用的な用途では十分良さそうという感触はありつつ、専門分野への適用は様子見かなと期待しすぎないように期待しながらウォッチしたいと思います。
*1:ただしこれらの数値はTypeSafe自身の公表値で、第三者による検証ではない点には注意が必要です。また「ハルシネーションしない」というのも、正確には「定義した選択肢以外を物理的に返せない」という意味で、選んだ選択肢自体が常に正しいという保証ではありません。